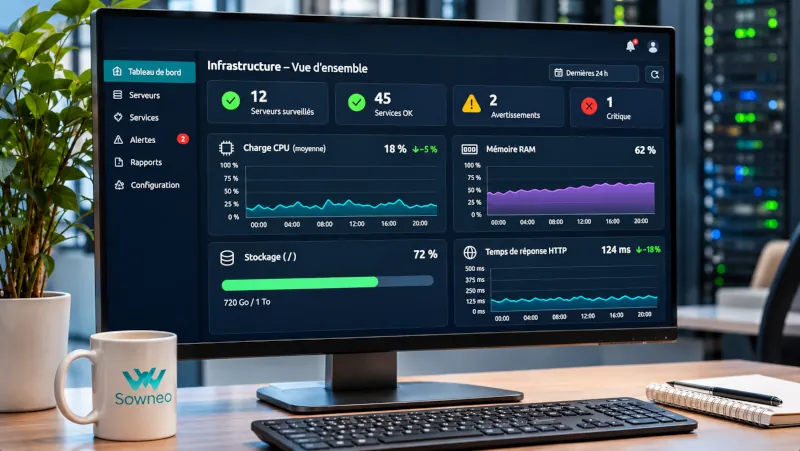
Une surcharge CPU, une saturation de l’espace disque ou des temps de réponse applicatifs anormaux peuvent annoncer une panne. La supervision serveur permet de repérer ces signaux avant qu’ils ne perturbent les applications métier et les services informatiques.
Sowneo utilise son propre outils de supervision, nommé Genesix, qui se distingue par une surveillance non intrusive, fondée sur des sondes SSH, sans installation d’un client de supervision ni modification du firewall.
Vous souhaitez superviser vos serveurs ?
Échangez avec Sowneo sur les besoins de surveillance de votre infrastructure.
Repérer les anomalies serveur avant une interruption de service
Un serveur informatique peut rester joignable alors qu’un service applicatif fonctionne mal. Ainsi, la surveillance des infrastructures informatiques doit porter sur les ressources système, mais aussi sur les applications hébergées.
La supervision proactive collecte des mesures, analyse leurs variations et signale les dysfonctionnements à examiner. Elle complète ainsi l’infogérance informatique, qui organise l’exploitation et le traitement des incidents au-delà de leur détection.
Analyser les métriques CPU, RAM et stockage pour détecter les dégradations
Le monitoring des ressources serveur suit plusieurs indicateurs : utilisation du processeur, pression mémoire et comportement du stockage. Cependant, une mesure isolée ne suffit pas toujours à caractériser un incident informatique.
Surveiller la charge CPU et la pression mémoire d'un serveur
Une utilisation élevée du processeur (CPU) peut ralentir le traitement des requêtes lorsque la charge reste soutenue. De même, une pression sur la mémoire RAM peut accroître les accès à l’espace d’échange (swap).
Par conséquent, l’analyse porte sur la durée des pics, la mémoire disponible et les temps de réponse applicatifs. Une mémoire RAM fortement utilisée ne signifie pas, à elle seule, qu’un serveur manque de mémoire disponible.
Contrôler la latence du stockage et les erreurs d'entrée-sortie
Le taux d’occupation des systèmes de fichiers ne décrit pas, à lui seul, l’état du stockage. La supervision examine aussi les latences de lecture et d’écriture et les erreurs d’entrée-sortie (I/O).
Ainsi, des accès disque anormalement lents peuvent retarder les requêtes des bases de données. Les erreurs I/O peuvent également révéler un incident matériel ou un défaut dans la chaîne de stockage.
Vérifier la disponibilité des serveurs web, des bases de données et des services réseau
Un serveur accessible sur le réseau ne garantit pas un service applicatif opérationnel. C’est pourquoi les équipes associent contrôles réseau et tests de disponibilité applicative.
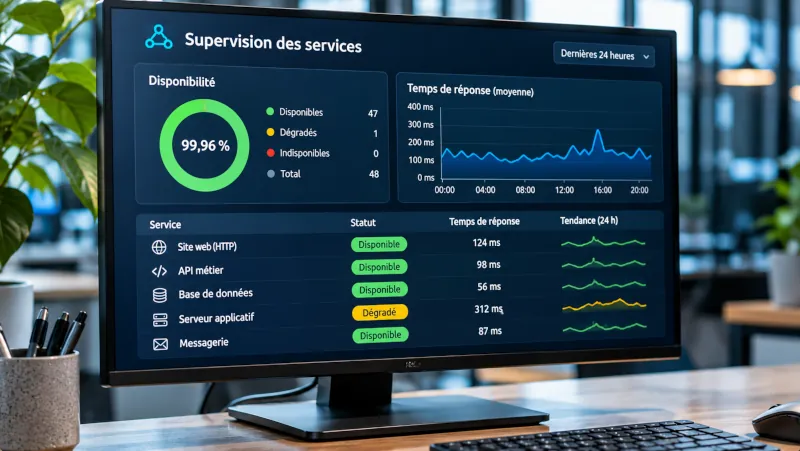
Mesurer les réponses HTTP et les erreurs des serveurs web
Un port TCP ouvert confirme une connexion possible, mais pas la bonne exécution d’une application web. En revanche, un test HTTP peut mesurer le temps de réponse du serveur web et relever les codes d’erreur HTTP.
Pour les services critiques, un test fonctionnel peut aussi vérifier une opération réellement attendue par l’utilisateur. Même un code HTTP 200 ne garantit pas le bon déroulement d’un parcours applicatif. Un service Web utilisant PHP-FPM avec un cache Fast_CGI ne peut être testé qu’après invalidation et régénération du cache, afin de tester le bon fonctionnement de toute la chaîne PHP.
Contrôler les connexions et les requêtes des bases de données
Une base de données peut accepter une connexion tout en répondant lentement aux requêtes applicatives. Une base de données est également sujette à un OOM kill par le système d’exploitation si la mémoire est trop sollicitée. Ainsi, la supervision des bases de données peut mesurer les délais de connexion, les erreurs et les requêtes de contrôle.
Ces vérifications concernent notamment les applicatifs serveurs utilisés pour héberger des bases de données et des services web.
Configurer des seuils d'alerte pour la CPU, la RAM et les espaces disque
Les seuils d’alerte serveur servent à signaler une saturation des ressources système ou une indisponibilité applicative. Toutefois, un seuil générique peut multiplier les fausses alertes ou masquer une dégradation réelle.
CPU
RAM
Stockage
Adapter les seuils à la charge habituelle des serveurs
Les équipes interprètent le taux d’utilisation CPU selon les applications et les périodes d’activité. De même, les alertes sur la mémoire RAM doivent distinguer la consommation normale d’une véritable pression mémoire.
Pour le stockage, la capacité disque restante et sa vitesse de consommation apportent davantage qu’un simple pourcentage d’occupation.
Déclencher les alertes sur les anomalies persistantes
Un pic ponctuel de charge CPU ne justifie pas nécessairement une intervention. Ainsi, une alerte de supervision peut exiger qu’un dépassement persiste pendant une durée définie.
En revanche, une indisponibilité d’application critique peut imposer une remontée plus rapide. Les règles dépendent de l’impact métier et des procédures d’exploitation retenues.
Prioriser les alertes selon la criticité des serveurs et des applications
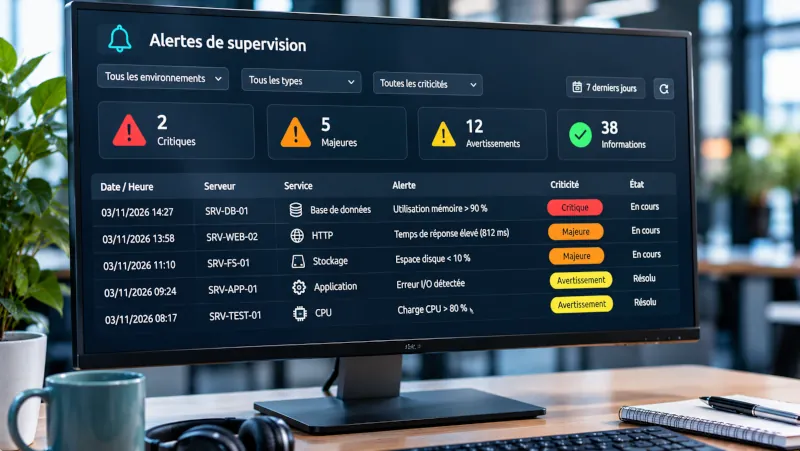
La gestion des alertes de supervision doit distinguer les anomalies techniques des incidents qui affectent réellement les utilisateurs. Cette priorisation évite de traiter toutes les notifications avec le même degré d’urgence.
Évaluer l'impact des alertes sur les applications de production
Une surcharge CPU sur un serveur de test n’a pas le même impact qu’une base de données de production indisponible. Par conséquent, les équipes évaluent chaque alerte selon la criticité du service informatique concerné.
Regrouper les alertes corrélées pour réduire le bruit de supervision
Une coupure réseau peut déclencher plusieurs alertes d’indisponibilité sur les serveurs et applications d’un même site. En regroupant ces notifications, les équipes évitent de confondre un incident unique avec plusieurs pannes indépendantes.
Transmettre les alertes critiques avec des données de diagnostic
Une notification d’incident serveur doit identifier l’équipement, le service touché, la métrique concernée et l’heure de détection. Ainsi, l’équipe technique dispose d’un premier contexte pour lancer le diagnostic de l’incident informatique.
La transmission reste toutefois distincte de la résolution : la réception d’une alerte ne prouve pas le début d’une action corrective.
Détecter une saturation disque avant l'échec des écritures en base de données
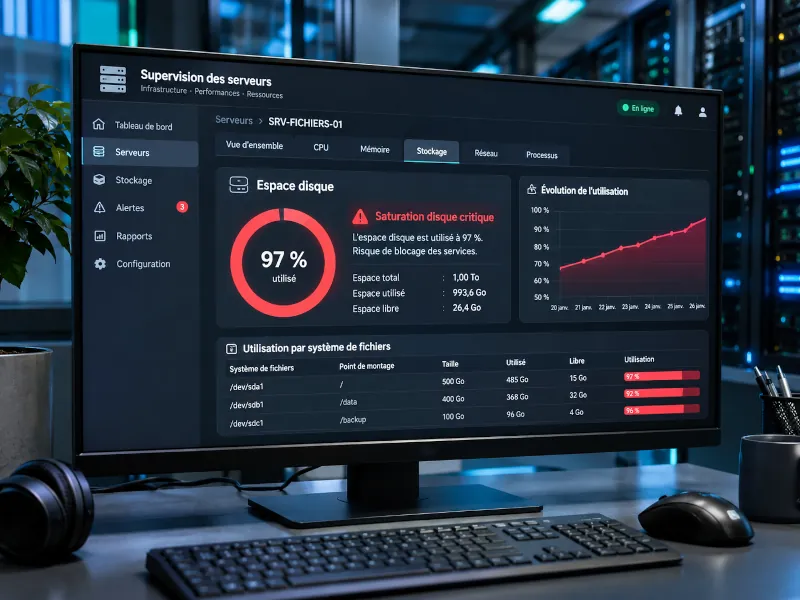
Une saturation du système de fichiers peut empêcher une base de données d’enregistrer de nouvelles écritures. Par exemple, la croissance des journaux applicatifs ou des fichiers temporaires peut consommer l’espace libre.
Grâce au suivi de l’espace disque disponible, une équipe peut identifier cette tendance avant le blocage. Elle peut alors rechercher la cause et prévoir une extension du volume de stockage, si nécessaire.
Cependant, une alerte d’occupation disque ne précise pas quels fichiers supprimer sans risque. L’équipe vérifie donc leur rôle et leurs contraintes de conservation avant toute action.
Prévoir les besoins en capacité CPU, RAM et stockage des serveurs
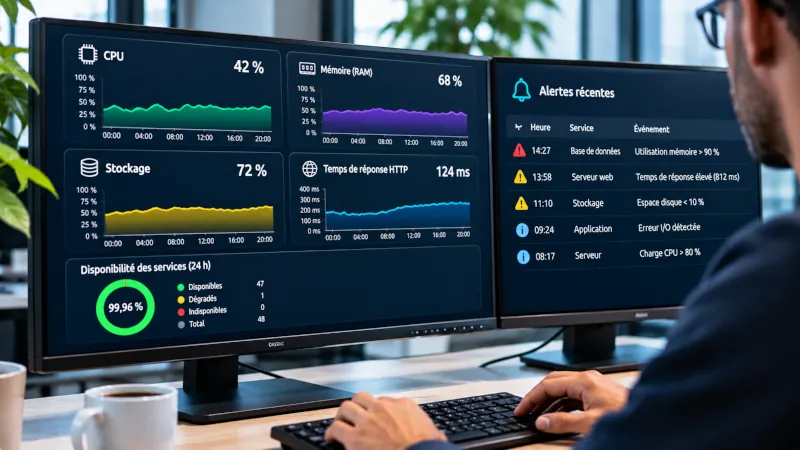
L’historique des métriques serveur permet de suivre la croissance de la consommation des ressources sur plusieurs semaines. Ainsi, l’évolution de la mémoire disponible, de la charge CPU et du volume de données stockées éclaire les besoins futurs.
Cette planification de capacité informatique aide à préparer une augmentation des ressources avant une saturation. Toutefois, les projections doivent intégrer les pics d’activité applicative, les changements d’usage et les nouveaux projets.
Associer supervision serveur et infogérance pour traiter les incidents informatiques
La supervision serveur détecte des symptômes, mais ne remplace ni le diagnostic ni l’administration des systèmes. L’infogérance informatique peut prendre le relais pour organiser le traitement, selon le périmètre contractuel retenu.
Relier les alertes système au diagnostic des incidents serveur
Une alerte de saturation mémoire peut révéler une hausse légitime de charge ou un comportement applicatif inhabituel. Les équipes confrontent donc les métriques système aux journaux applicatifs et aux événements récents avant toute correction.
Définir les responsabilités d'intervention sur les infrastructures Linux
Sowneo accompagne les entreprises dans l’infogérance des infrastructures Linux et la gestion des services informatiques. Toutefois, chaque projet doit préciser les modalités de supervision, de transmission des alertes et d’intervention.
Vos serveurs de production hébergent des applications ou des données essentielles ?
Contactez Sowneo pour étudier la supervision de votre infrastructure informatique.